Hinweis: Konzept-Prototyp auf Beispieldaten, entstanden als eigenes Projekt. Er ist nicht für einen Arbeitgeber gebaut und wird bei keinem betrieben.
Worum es geht
Der ITSM-Betrieb besteht aus vielen Werkzeugen: Monitoring, Ticketsystem, Backup-Berichte, Provider-Reports. Jedes zeigt einen Ausschnitt, aber die Frage „Was braucht heute meine Aufmerksamkeit?" beantwortet keines. Ops Control Center legt sich als eine Arbeitsoberfläche über die vorhandenen Werkzeuge (Azure Monitor, M365 Service Health, Backup- und Provider-Berichte, Jira). Es ersetzt keine ITSM-Suite.
Die Idee: die Regeln sind das Produkt
Das Kernstück ist ein Regelwerk, das Daten in eine priorisierte Liste mit Handlungsbedarf übersetzt. Jeder Eintrag trägt die ID der Regel, die ihn ausgelöst hat. Nichts davon ist Magie oder Black Box:
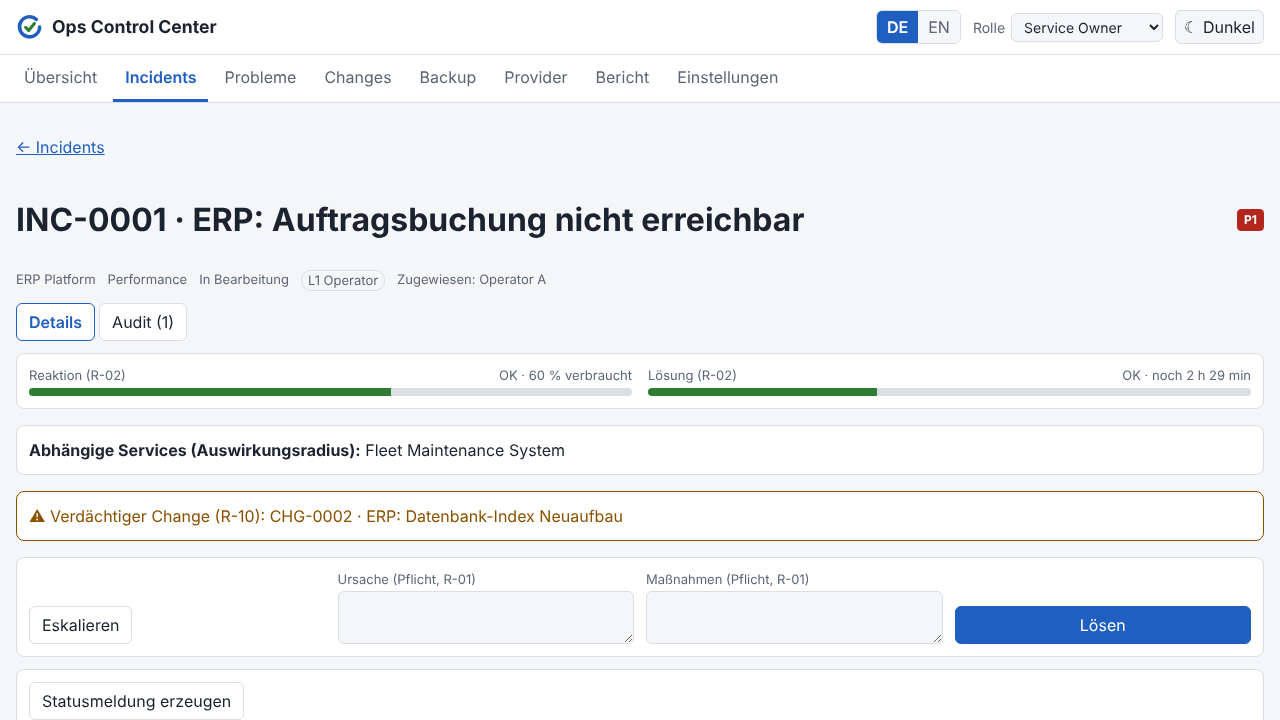
- Incidents: SLA-Uhren nach Priorität (P1: 15 Min. Reaktion, 4 h Lösung), Eskalation L1 → L2 → L3, P1/P2 nur mit Ursache und Maßnahmen abschließbar, Post-Incident-Review innerhalb von 5 Tagen.
- Probleme: Ab drei Incidents am selben Service und in derselben Kategorie innerhalb von 30 Tagen entsteht ein Problem-Kandidat. Known Errors älter als 60 Tage werden gemeldet.
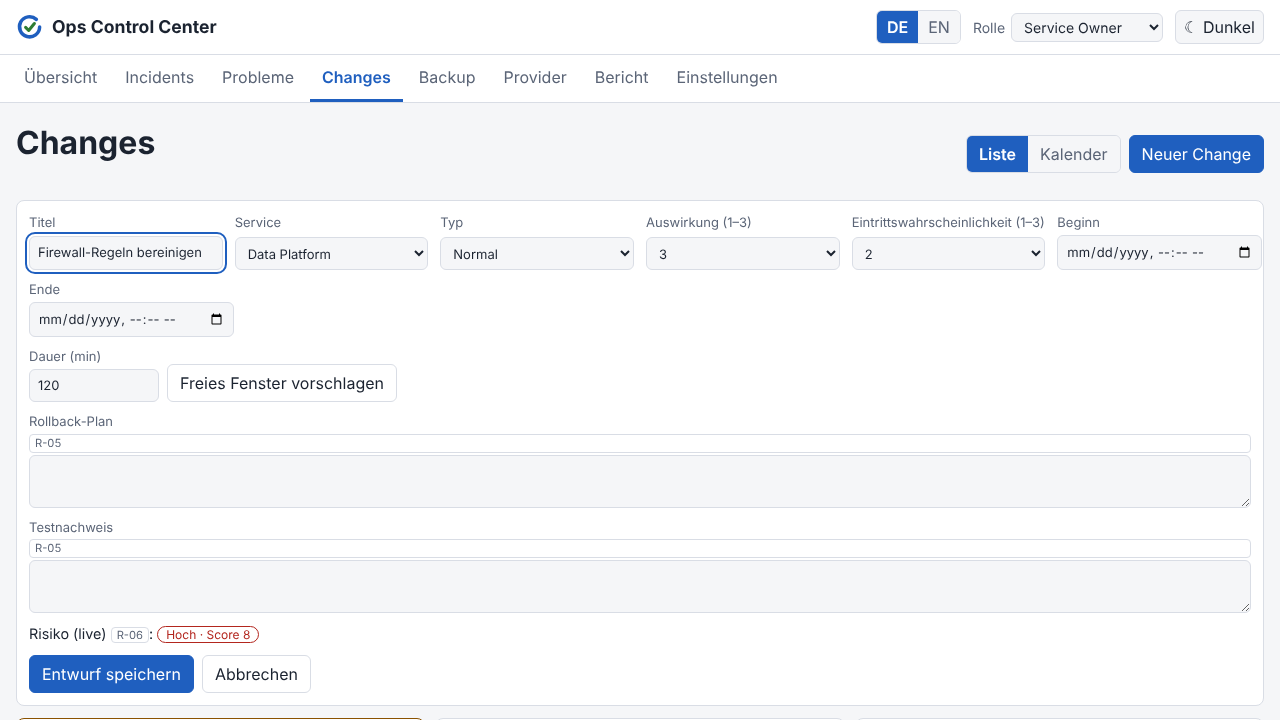
- Changes: Rollback-Plan und Testnachweis sind Pflicht, das Risiko wird aus Auswirkung, Wahrscheinlichkeit, fehlendem Wartungsfenster und offenen P1/P2 berechnet, Freigaben richten sich nach Risikoband und Rolle, bei offenem P1 gilt ein Change-Freeze, überlappende Changes werden gewarnt, und ein Change kurz vor einem Incident gilt als Verdächtiger.
- Backup und Recovery: RPO-Verletzung, RTO-Balken und überfällige Restore-Tests nach 90 Tagen.
- Provider und SLA: KPIs unter Vertragsniveau, Error Budget je Service, Frist für Service-Credit-Anträge.
- Nachvollziehbarkeit: Jede Schreiboperation landet unveränderlich im Audit-Trail.
Abgeleitete Werte wie SLA-Status, Risiko, Budget und Aktionsliste werden bei jedem Lesen berechnet, nie von Hand gepflegt.
Produktentscheidungen und warum
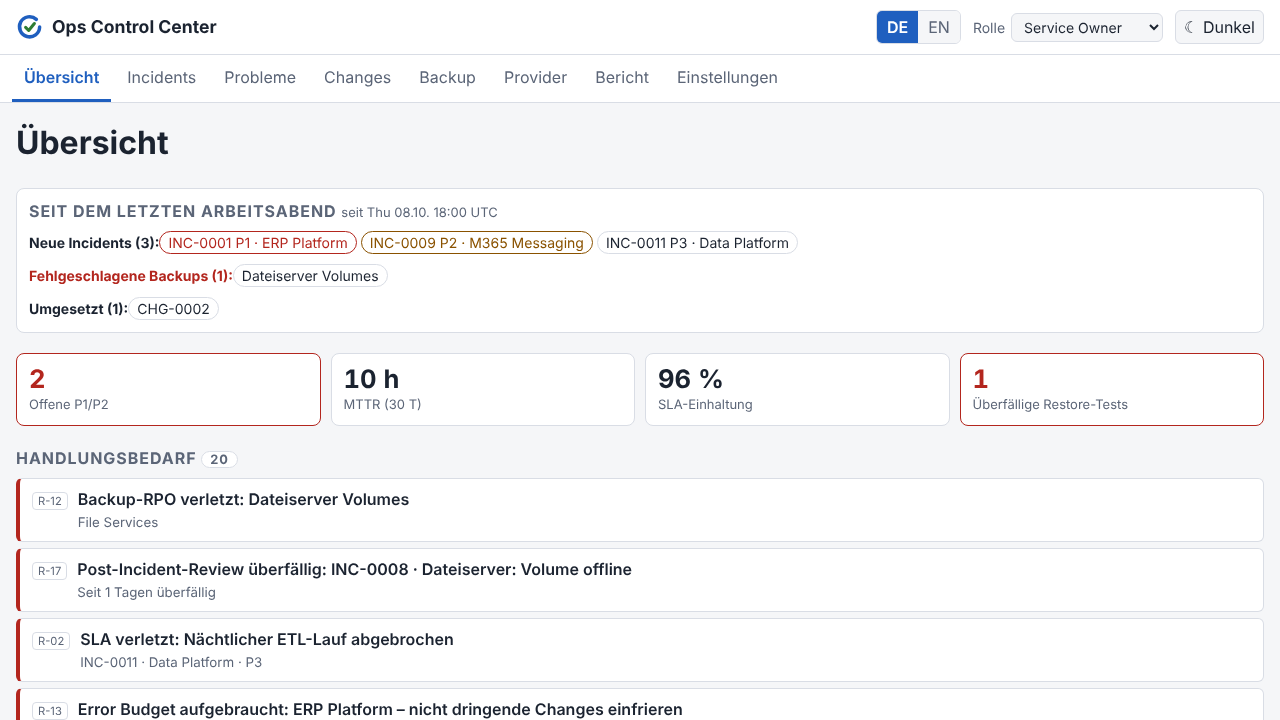
- Übersicht auf „Was ist heute zu tun?" reduziert. Die erste Version war überladen. Jetzt führt die Startseite mit dem Handlungsbedarf und einem Digest seit dem letzten Arbeitstag.
- Regeln statt KI-Antworten. Ein Chatbot über den Daten wurde bewusst zurückgestellt: Er würde Daten an ein externes Modell senden, und die These des Produkts ist deterministische Nachvollziehbarkeit.
- Quellsysteme umgehen den Workflow nie. Auch wenn Jira ein Ticket ändert, bleiben Freigaben und Rollen der Anwendung maßgeblich.
- Fehlende Daten. Ein Backup-Set ohne gemeldeten Lauf gilt als „noch keine Daten", nicht als Verstoß.
- Desk Research statt Interviews. Marktrecherche (auf Anbieterniveau) hat die späteren Phasen gesteuert. Ein Interview-Leitfaden liegt für später bereit.
Wie es aufgebaut ist
- Dashboard-Reiter: Übersicht, Incidents, Probleme, Changes, Backup, Provider, Bericht, Einstellungen.
- Konnektoren: Azure Monitor, M365 Service Health, Backup-Berichte, Provider-Reports, generischer Webhook und Jira (live, per Abfrage). Eingehende Daten sind signiert und werden idempotent verarbeitet.
- Modi: Demo mit Beispieldaten und simulierten Rollen, Live-Modus mit Anmeldung, Sitzungen, Rollen und CSRF-Schutz.
- Qualität: Test-Driven Development, Barrierefreiheitsprüfung mit axe auf jeder Seite, Deutsch als Standard und Englisch umschaltbar, helles und dunkles Design.
Was noch fehlt
Windows-Installationsdateien wurden noch nicht auf einem echten Windows-Server ausgeführt. Außer Jira laufen die Konnektoren mit Beispieldaten. MFA und Single Sign-on fehlen noch. Eine Live-Demo zeige ich gern im Gespräch.